AGI-Eval
AI大模型评测社区
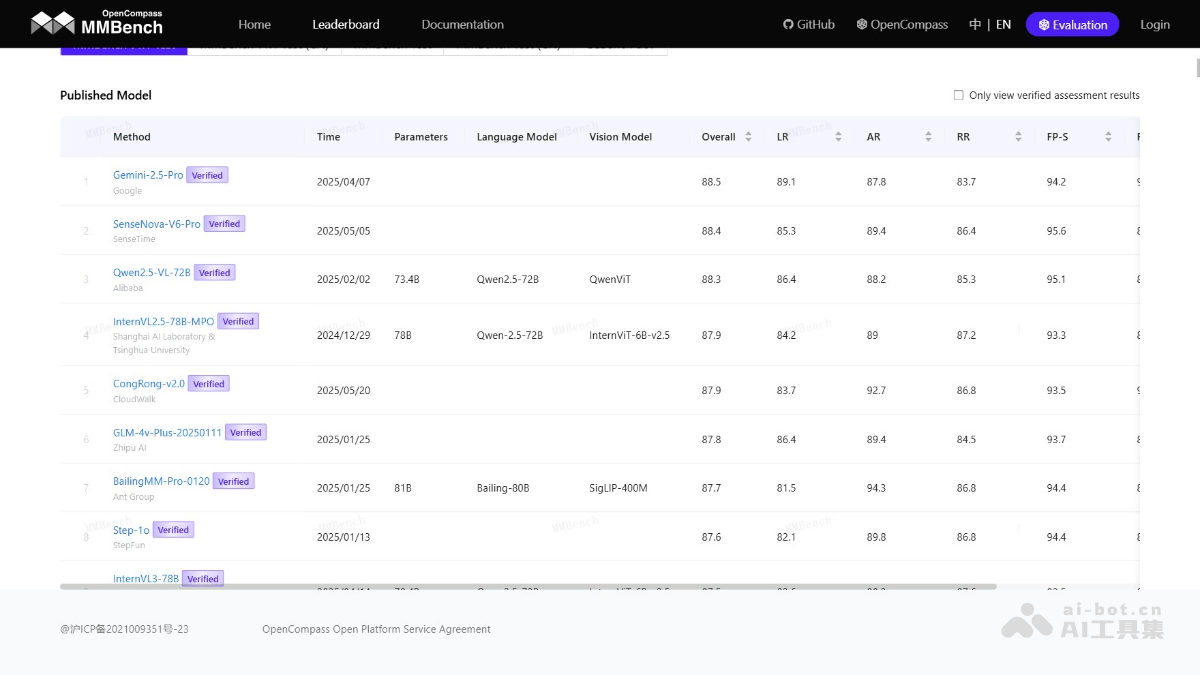
MMBench是用于考察多模态模型的评测基准,关注模型如何结合图像和文字理解问题。它适合研究视觉语言能力,阅读结果时需要了解题型、数据划分和评分方法。
专业领域的评测结果属于研究依据。它不能替代实际业务验证,也不能直接替代专业人员对具体问题的判断。
需要比较模型、设计实验或研究评估方法的开发者和研究人员。
实际使用示例:比较模型在图像细节理解和关系推理上的表现,而不只观察总分。
不能只看排名。任务分布、输入方式和评测设置都可能影响结果,应结合实际应用测试。
通常不能。数据、指标和题型不同,数值意义也不同。
保留资源版本、运行配置、提示和完整结果,明确模型与调用环境。
本站AI模型评测分类整理相关基准与平台入口,可按任务方向比较。