CMMLU
一个综合性的大模型中文评估基准
 H2O Eval Studio
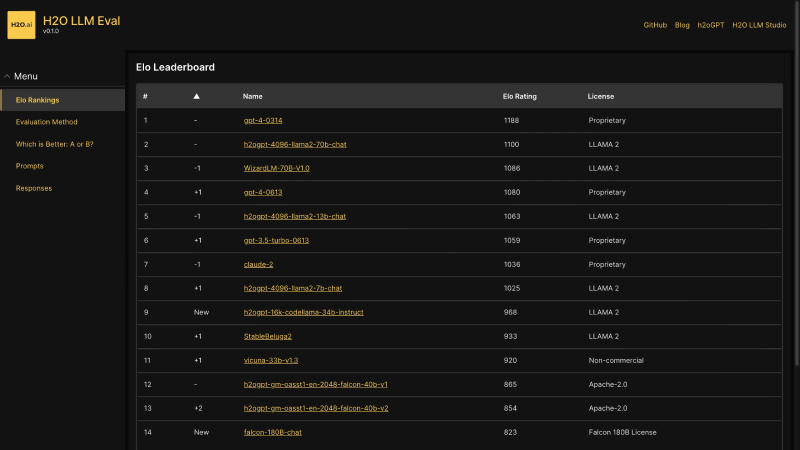
H2O的模型评测产品目前可通过H2O Eval Studio官方资料了解与使用。它围绕模型主机、测试集、评估器和结果分析组织LLM评测;原EvalGPT公开演示入口已变化,不应再把它介绍为无需条件即可访问的免费排行榜。
专业领域的评测结果属于研究依据。它不能替代实际业务验证,也不能直接替代专业人员对具体问题的判断。
需要比较模型、设计实验或研究评估方法的开发者和研究人员。
使用示例:团队比较两个问答模型时,可以固定测试材料和评估方式,保留配置与结果,再用业务样本检查结论是否适用。
不能只看排名。任务分布、输入方式和评测设置都可能影响结果,应结合实际应用测试。
通常不能。数据、指标和题型不同,数值意义也不同。
保留资源版本、运行配置、提示和完整结果,明确模型与调用环境。
本站AI模型评测分类整理相关基准与平台入口,可按任务方向比较。