ChatLaw

14小时前发布 2 0 0

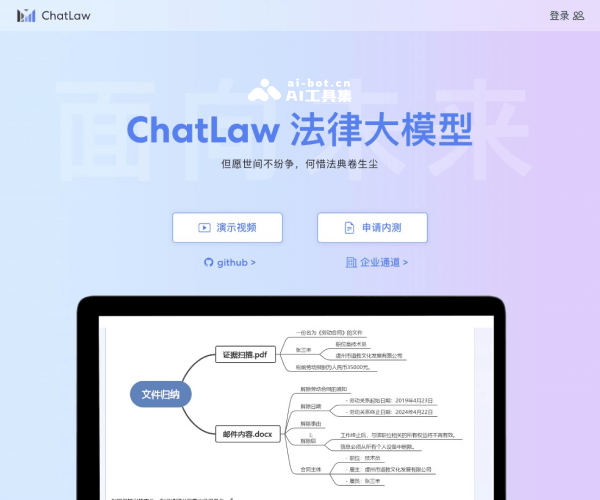
北大开源的法律大模型和助手

收录时间:
2026-11-10

ChatLaw是什么?

ChatLaw是面向中文法律语言处理的开源研究项目,提供法律模型、相关论文与实现资源。它围绕知识检索、多智能体协作和法律问答等方向开展研究,适合开发者与研究人员阅读和测试。项目资源与在线法律服务需要区分,代码和模型许可、运行条件及数据时效应分别确认。

选择模型时,应同时检查资源本身和实际服务条件。相同品牌下的不同模型与应用可能有明显差别。
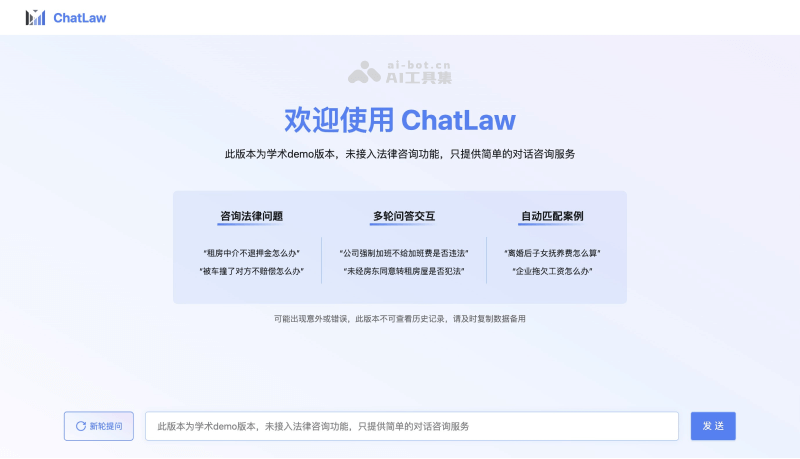
ChatLaw研究项目前端原型示例

ChatLaw的主要功能

  • 法律模型:阅读不同模型资源的定位与要求。
  • 文本处理:探索法律问题与文档的语言任务。
  • 检索增强:结合资料检索减少缺失上下文。
  • 协作流程:研究不同分析环节的组织方式。
  • 论文资料:了解方法、数据和评测条件。
  • 开源实现:按仓库说明配置研究环境。
  • 样本验证:使用可复核材料检查输出局限。

如何使用ChatLaw?

  1. 明确模型任务:先确定是文字、视觉、语音还是其他输入输出需求。
  2. 阅读资源说明:检查模型卡、运行要求、接口方式与使用条件。
  3. 选择体验入口:区分用户产品、在线服务与可自行运行的模型资源。
  4. 用样本验证:以自己的真实材料测试效果,记录错误和不稳定情况。
  5. 再做集成决定:结合部署环境、服务限制与维护成本选择后续方案。

适合哪些人使用?

AI开发者、研究人员和需要选择基础模型资源的团队。

使用示例:开发者先阅读模型说明与许可,使用公开测试材料验证引用和回答,再决定是否用于研究系统。

官网与相关入口

常见问题

模型和AI应用有什么区别?

模型提供基础能力,应用还包括界面、工具与工作流程。选择时应确认自己需要哪一层。

看到演示效果就能直接用于业务吗?

还需要用实际数据测试输入限制、结果稳定性和失败情况。

可以下载或自行部署吗?

取决于具体资源是否开放,以及许可证与运行要求,不能仅凭品牌名称判断。

哪里能找其他模型资源?

本站AI训练模型分类和AI开发平台分类提供相关入口。

数据统计

相关导航

暂无评论

none
暂无评论...