Chunkr

17小时前发布 2 0 0

Lumina AI 推出的开源文档处理API

收录时间:
2026-11-10

Chunkr是什么?

Chunkr提供面向复杂文档的解析与结构化处理API,适合为知识库、搜索和RAG流程准备资料。它关注文字之外的版面、阅读顺序、边界位置和出处,使后续系统更容易关联原始材料。用户可根据文件类型与任务设置输出,而不是把所有文档简单拼成一段文本。

文档处理的结果需要能够回到原始材料。把内容、结构、位置与业务字段一起核对,通常比只检查是否返回JSON更能发现实际问题。
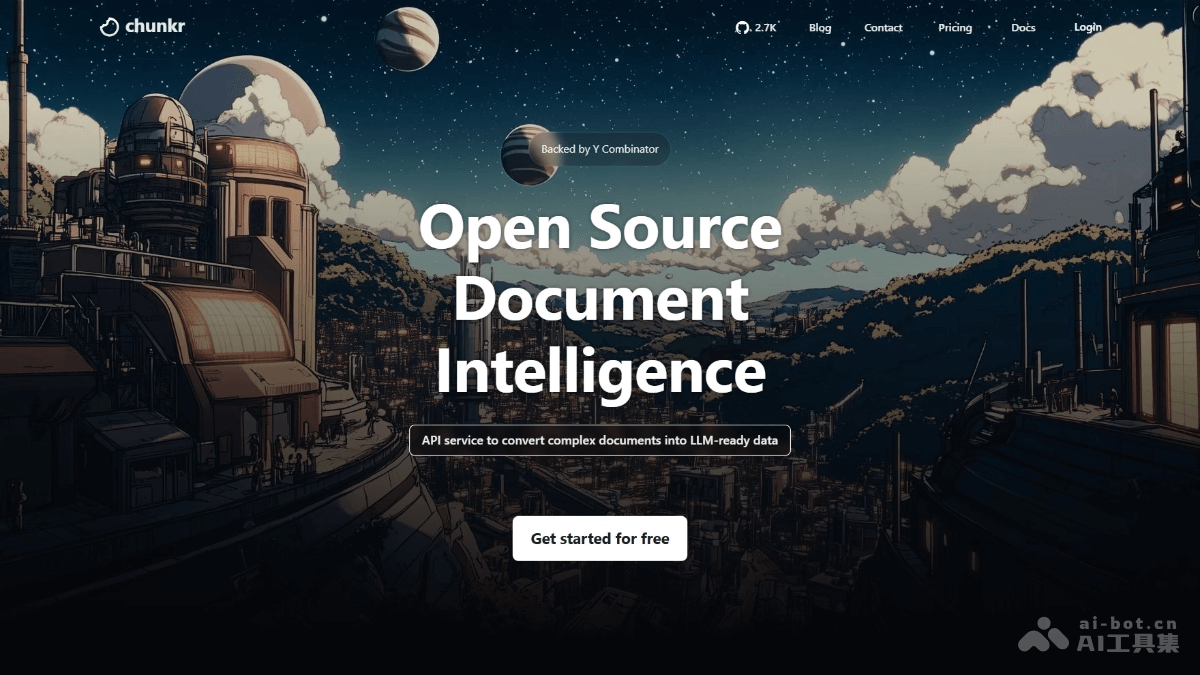
Chunkr 产品界面示例

Chunkr的主要功能

  • 文档解析:处理PDF、图片和其他支持资料,检查复杂页面中的内容。
  • OCR与布局:识别文字并保留位置、版面与阅读顺序等信息。
  • 分块组织:把资料切分成便于检索和模型处理的内容单元。
  • 结构化输出:按任务使用HTML、Markdown或JSON等结果。
  • 字段提取:围绕指定结构整理需要的数据,检查漏项与类型。
  • 开发衔接:通过API或SDK接入处理流程,记录任务、错误与来源信息。

如何使用Chunkr?

  1. 定义输出结构:先确定需要的字段、类型、单位与来源定位信息。
  2. 准备真实样本:选取清晰且有权处理的文件,覆盖主要版式与异常情况。
  3. 测试官方入口:根据文档使用工作台、SDK或API,区分提交任务与取得最终结果。
  4. 核对识别内容:检查字段遗漏、表格关系、阅读顺序和低质量扫描件。
  5. 接入业务流程:验证重试、重复文件与人工复核方式,再处理更大规模资料。

适合哪些人使用?

需要将文档识别、字段提取和结构化资料处理接入系统的开发者与业务团队。

使用示例:开发者先解析一组公开报告,核对表格和阅读顺序,再把内容块连同出处放进检索系统。

官网与相关入口

常见问题

结构化输出能直接写进业务系统吗?

应先检查字段含义、格式、空值和关键数字,并安排需要人工确认的情况。

为什么同一种文件结果不同?

扫描清晰度、版式、手写内容和任务配置都会影响识别,需要用实际样本验证。

RAG分块越小越好吗?

块大小应保留必要上下文,同时方便定位原文,不能只依据数量选择。

开发接入需要保留什么?

记录任务标识、原文件、输出版本和错误状态,便于检查重复处理与后续复核。

可在本站的 AI开发平台 分类浏览更多相关入口。
数据统计

相关导航

暂无评论

none
暂无评论...