Scikit-learn

17小时前更新 3 0 0

Python机器学习库

收录时间:
2026-11-10
Scikit-learnScikit-learn

Scikit-learn是什么?

Scikit-learn是Python生态中的机器学习库,适合分类、回归、聚类、降维与预测数据分析。它提供相对统一的接口,把预处理、模型选择和评估组织为可组合的流程。使用者可以从传统方法建立清楚的基线,再根据数据与任务比较,而不是先追求复杂模型。

开发工具需要放在真实任务中理解。先建立可复现的小例子,再扩大数据与系统范围,有助于区分环境问题、接口问题和实际方法问题。
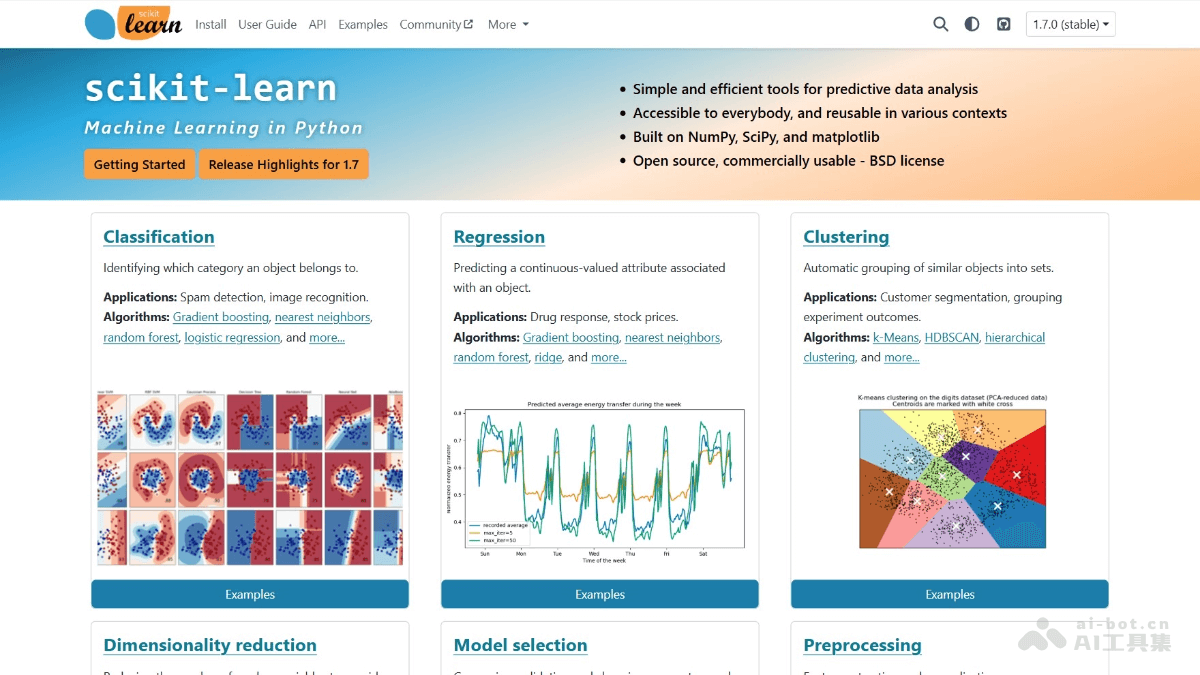
Scikit-learn 产品界面示例

Scikit-learn的主要功能

  • 分类与回归:对离散类别或连续数值建立预测模型,选择适合任务的评价方式。
  • 聚类分析:按照数据特征探索分组,再判断分组是否具有实际意义。
  • 降维与选择:减少特征或表达复杂度,核对信息损失与解释需求。
  • 数据预处理:处理缩放、编码和缺失信息,保留训练与预测的一致性。
  • 交叉验证:比较模型与参数,避免仅凭单次训练结果作结论。
  • Pipeline组合:把预处理与估计器组成流程,减少不同阶段的数据处理差异。

如何使用Scikit-learn?

  1. 选择当前文档:先确定任务,再阅读与安装版本一致的指南和接口说明。
  2. 准备独立环境:根据官方安装说明确认语言、依赖与硬件条件,避免直接改动已有生产环境。
  3. 运行最小示例:用少量可检查的数据验证输入、输出与实际接口。
  4. 检查任务结果:核对形状、数据类型、单位、指标和错误信息,区分程序能运行与结果正确。
  5. 记录与集成:保存版本、参数和必要的复现资料,再接入真实项目。

适合哪些人使用?

机器学习开发者、数据分析人员,以及需要理解相关工具接口的学生与研究者。

使用示例:数据分析人员用整理后的内容标签数据建立分类基线,再通过交叉验证比较特征与算法。

官网与相关入口

常见问题

必须使用GPU吗?

取决于具体工具、任务与数据规模,先查看官方硬件支持,不把加速设备当作所有场景的前提。

为什么网上的示例不能直接运行?

常见原因包括版本、依赖、接口变化和数据格式不同,应对照当前官方文档检查。

程序运行成功就代表结果可靠吗?

还需要验证输入、计算过程和输出含义,并用独立样本或已知结果比较。

怎样继续学习?

从官方入门、示例与API文档逐步展开,在一个范围清楚的小任务中验证理解。

可在本站的 AI开发平台 分类浏览更多相关入口。
数据统计

相关导航

暂无评论

none
暂无评论...