QMuse
蚂蚁集团推出的AI无代码应用生成平台
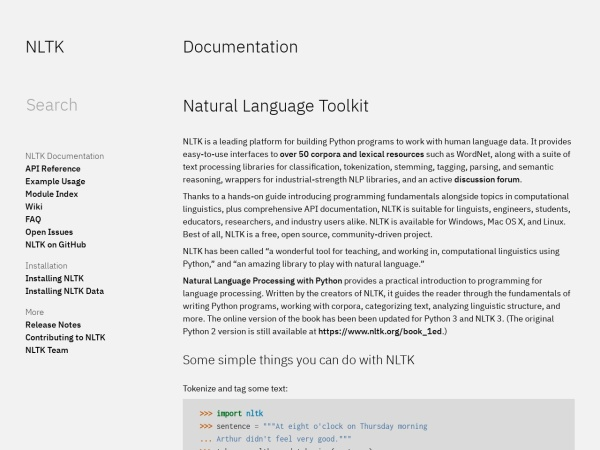
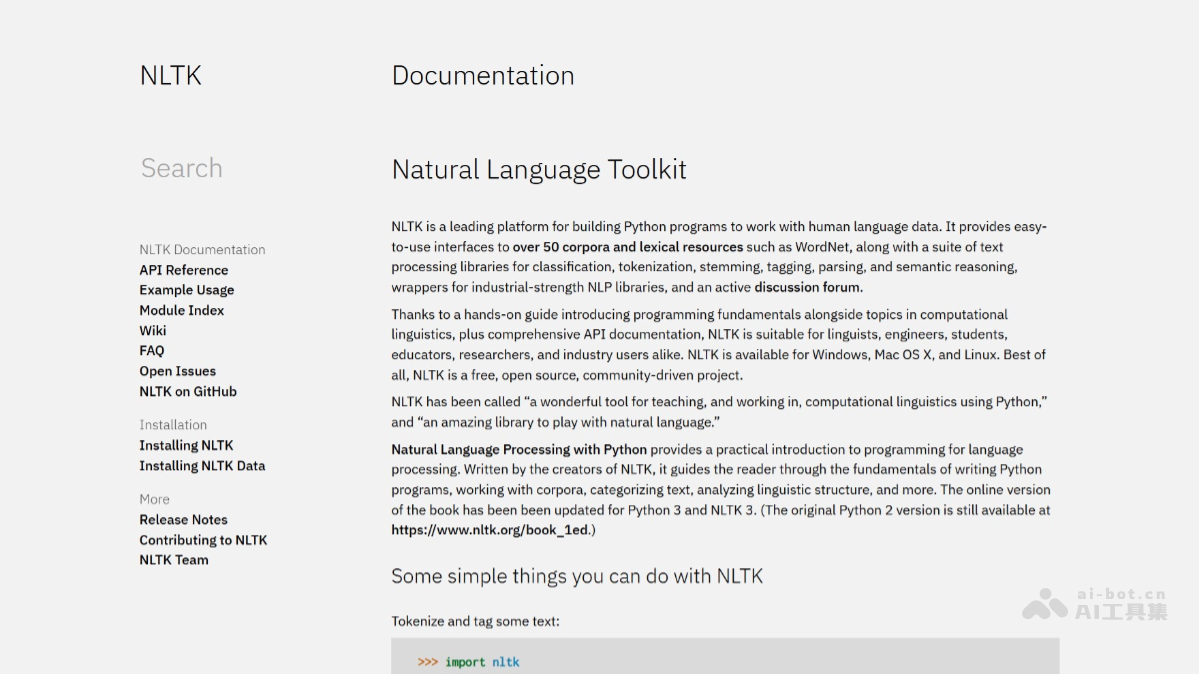
NLTK 是用于处理自然语言资料的 Python 工具集,包含分词、词性标注、词干处理、分类和句法分析等组件,并配有语料资源接口、学习书籍和 API 文档。它适合语言处理教学、实验及资料预处理,需要编写程序使用。不同语言、算法和语料资源的适用范围各不相同,准备任务时应分别核对,不能把英文演示效果直接套用到所有语言。
语言处理应从真实资料与明确任务开始。先检查小样本的输入输出,再决定方法怎样进入更长的处理流程。
语言处理学习者、研究人员与需要编写文本处理程序的开发者。
使用示例:学生用一组英文评论学习分词和分类,先检查清洗与标注,再比较结果;需要中文处理时另行确认适配的方法和资源。
这类工具以程序接口为主,需要结合代码、资源和处理流程使用。
语言、语料和算法支持不同,应按具体任务选择并检查效果。
分词只是处理环节之一,还需结合语境、标注与任务目标判断。
资源变化会影响输出,保留版本与样例便于复现和比较。
可在本站的 AI开发平台 分类浏览更多相关入口。