Caffe

1天前发布 3 0 0

用于学习与维护视觉模型工程的开源深度学习框架

收录时间:
2026-11-11

Caffe是什么?

Caffe 是由伯克利研究团队及社区开发的开源深度学习框架,主要通过模型配置、网络层和优化设置组织训练与推理。它在计算机视觉框架发展中具有代表性,官方网站保留教程、安装说明、模型资源和网络层参考。当前收录侧重学习与既有工程维护;官网中的早期硬件测试和性能宣传不能直接代表现在的设备或项目表现。

训练框架的价值在于可复现的方法与实现。明确环境和数据条件,再判断实际结果与后续改进方向。
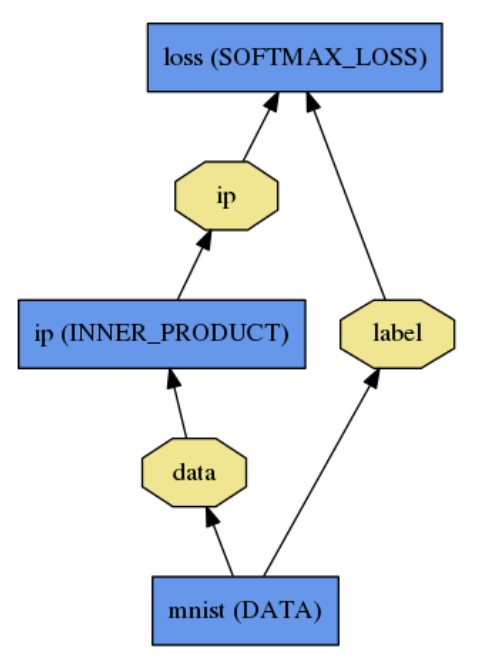
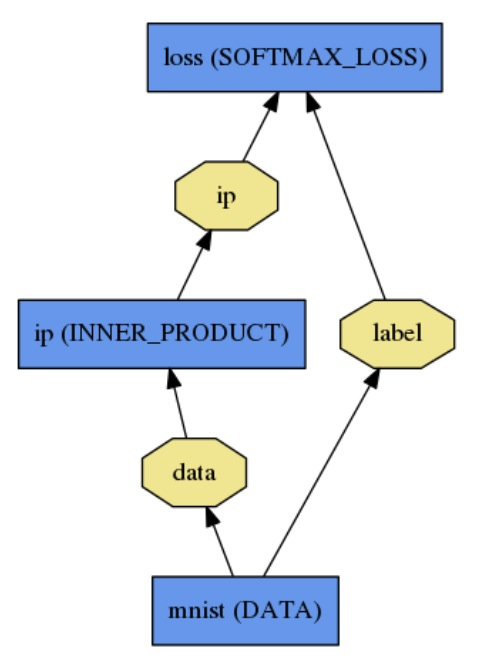
Caffe 产品界面示例
Caffe 官方教程中的 Softmax 网络结构图

Caffe的主要功能

  • 模型配置:用网络和求解器配置描述实验。
  • 网络层组织:通过层与数据流理解神经网络结构。
  • 训练与推理:区分参数学习和已训练模型的实际运行。
  • 计算后端:依据相应版本检查 CPU、GPU 与依赖支持。
  • 模型资源:阅读 Model Zoo 中具体模型的说明与条件。
  • 历史工程:结合原始文档理解旧项目,迁移时另行验证兼容性。

如何使用Caffe?

  1. 阅读项目:确认代码版本、许可证与维护状态。
  2. 理解流程:区分数据准备、训练、评估和推理环节。
  3. 准备环境:按官方说明核对硬件、依赖和数据要求。
  4. 小样验证:先用代表性任务检查格式、运行记录与输出。
  5. 记录实验:保留参数、数据口径和结果,再扩展训练规模。

适合哪些人使用?

研究大模型训练、微调与对齐流程的开发者和研究人员。

使用示例:开发者维护一个已有的图像分类项目,先记录原始网络与权重版本,使用少量样本复现输出,再判断继续维护还是迁移到其他框架。

官网与相关入口

常见问题

开源训练项目等于在线聊天网站吗?

代码、模型与托管演示是不同入口,应分别确认。

可以直接照旧教程运行吗?

依赖、硬件和模型可能已经变化,需要以当前项目说明为准。

一次结果能代表模型整体表现吗?

需要多类样例和可复现条件,不能用单次回答或旧榜单代替评估。

怎样比较实验结果?

固定数据范围、环境和评价方式,记录具体版本与差异。

可在本站的 AI训练模型 分类浏览更多相关入口。
数据统计

相关导航

暂无评论

none
暂无评论...